1. Elasticsearch 란?
Apache Lucene(아파치 루씬) 기반의 Java 오픈소스 분산 검색 엔진 방대한 양의 데이터를 '거의' 실시간 (NRT, Near Real Time)으로 저장, 검색, 분석할 수 있다.
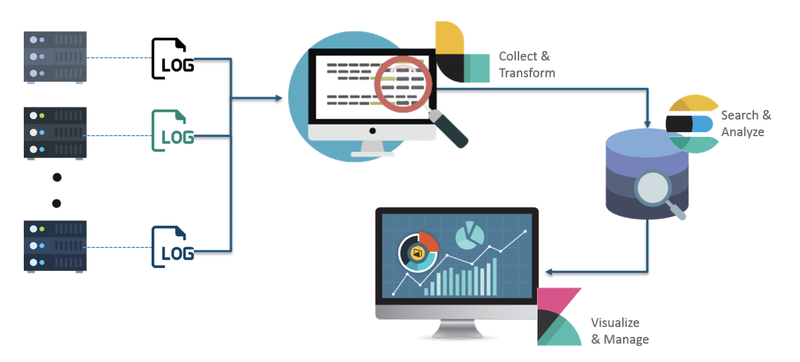
데이터 분석 도구인 ELK 스택에서 데이터 분석 및 저장 기능을 담당하기도 하고 (Logstash : 수집기능 / K - Kibana : 시각화), 단독으로 사용되기도 한다.
모든 종류의 문서를 검색하는데 사용할 수 있으며, 분산 방식으로 데이터를 처리한다. 인덱스를 여러 샤드로 나눌 수 있으며 각 샤드는 복제를 가질 수 있다. 각 노드는 하나 이상의 샤드를 관리하며 작업을 올바른 샤드로 할당시킨다. 리밸런싱이나 라우팅은 자동으로 수행된다.
ELK
Logstash가 다양한 데이터 (로그 또는 트랜잭션 데이터 등)을 수집, 집계, 파싱하여 Elasticsearch로 전달한다. Elasticsearch는 전달받은 데이터를 검색 및 집계하여 필요한 정보를 획득한다.
Kibana는 Elasticsearch의 빠른 검색을 통해 데이터를 시각화 및 모니터링한다.
2. Elasticsearch와 RDB 비교
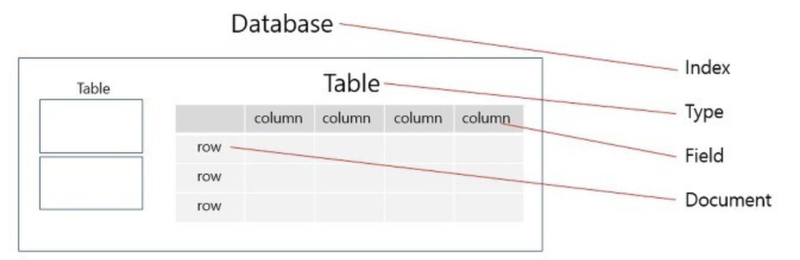
개념 파악을 위해, ES에서 사용되는 데이터 구조를 RDBMS에 대응해보면 다음과 같이 맵핑된다.
간단한 버전
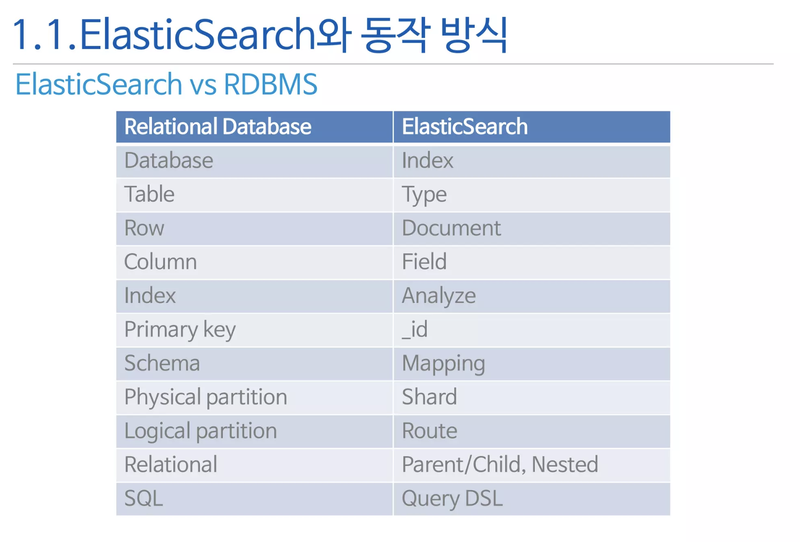
테이블들을 가지고 있는 데이터베이스 = Index
컬럼과 로우들로 구성된 테이블 = Type
데이터 객체 하나의 속성들을 나타내는 컬럼 = Field
각 속성들로 이루어진 하나의 데이터 = Document
인덱스 = Analyze
테이블의 컬럼들 중에서 각 로우들을 구별하기 위해 사용되는 컬럼인 프라이머리키 = _id
물리적 파티션 = shared (샤드)
논리적 파티션 = Route
relational = parent/child, nested
SQL = Query DSL
Elasticsearch의 HTTP METHOD와 SQL
ElasticSearch는 기본적으로 http 프로토콜로 접근이 가능한 REST API를 통해 데이터 조작을 지원한다. 이를 RDBMS의 SQL과 맵핑해보면 다음과 같다.
|
ElasticSearch |
RDBMS SQL |
|
GET |
SELECT |
|
PUT |
INSERT |
|
POST |
UPDATE, SELECT |
|
DELETE |
DELETE |
|
HEAD 인덱스 정보 확인 |
|
3. 역색인
일반적인 색인의 목적은 ‘문서의 위치’에 대한 index를 만들어서 빠르게 그 문서에 접근하고자 하는 것인데, 역색인은 반대로 ‘문서 내의 문자와 같은 내용물’의 맵핑 정보를 색인해놓는 것이다.
종종 보았던, 책 마지막 파트에 책에 나왔던 단어들이 주르륵 정리 되어 있는 것을 생각하면 이해가 쉽다. 일반 색인(forward index)은 책의 목차와 같은 의미이고, 역색인(inverted index)은 책 가장 뒤의 단어 별 색인 페이지와 같다.
모든 단어가 어떤 document에 있는지 색인해두는 것을 역색인이라고 한다.
역색인은 검색엔진과 같은 문서의 내용의 검색이 필요한 형태에서 전문 검색의 형태로 주로 쓰인다.
만약 DB에서 “Blue”라는 문구가 포함된 문자열을 찾으려고 한다면 SQL에서는 %Blue% 라고 명확히 입력해야 검색이 가능하다. blue, BLUE, BLue…. 등의 문자열은 직접 하나하나 명시하기 전에는 찾을 수 없다. ES의 역색인을 활용하면 대소문자 구분 없이 어떤 문구가 들어와도 찾을 수 있다.
4. Elasticsearch 특징과 장단점
Elasticsearch는 분산처리를 통해 준실시간성으로 빠른 검색이 가능하다. 특히 기존의 데이터로 처리하기 힘든 대량의 비정형 데이터 검색이 가능하며 전문 검색(full text) 검색과 구조 검색 모두를 지원한다.
기본적으로는 검색엔진이지만 MongoDB나 Hbase와 같은 대용량 스토리지로도 활용이 가능하다.
Elasticsearch 장점
Schemaless. 동적스키마 생성이 가능하여 기존 RDBMS 데이터들에 대해 미리 스키마를 정의하지 않아도 동적으로 스키마 생성이 가능하다.
별도의 클라이언트 프로그램 없이 HTTP 기반의 RESTful 를 사용할 수 있고, 요청/응답에 JSON을 사용해 개발 언어, 운영체제, 시스템에 관계없이 다양한 플랫폼에서 활용이 가능하다.
Multi-tenancy
여러 계층 구조의 문서로 저장이 가능하며, 계층 구조로된 문서도 한번의 쿼리로 쉽게 조회할 수 있다.
역색인(Inverted Index)
분산 구성이 가능하다. 분산 환경에서 데이터는 shard라는 단위로 나뉜다.
내용 전체를 색인해서 특정 단어가 포함된 문서를 검색할 수 있다. 기능별, 언어별 플러그인을 적용할 수 있다.
비정형 로그 데이터를 수집하여 통계 분석에 활용할 수 있다. Kibana를 연결하면 실시간으로 로그를 분석하고 시각화할 수 있다.
고가용성을 위한 클러스터 구성. 한대 이상의 노드로 클러스터 구성하여 안정성을 보장하고 부하분산이 가능하다.
Elasticsearch 단점
완전한 실시간이 아니다. 색인된 데이터는 1초 뒤에나 검색이 가능하다. 내부적으로 commit과 flush같은 복잡한 과정을 거치기 때문이다.
Transaction Rollback을 지원하지 않는다.
전체적인 클러스터의 성능 향상을 위해 시스템적으로 비용 소모가 큰 롤백과 트랜잭션을 지원하지 않는다.
데이터의 업데이트를 제공하지 않는다.
업데이트 명령이 올 경우 기존 문서를 삭제하고 새로운 문서를 생성한다. 업데이트에 비해서 많은 비용이 들지만 이를 통해 불변성(Immutable)이라는 이점을 취한다.
Elasticsearch 구조
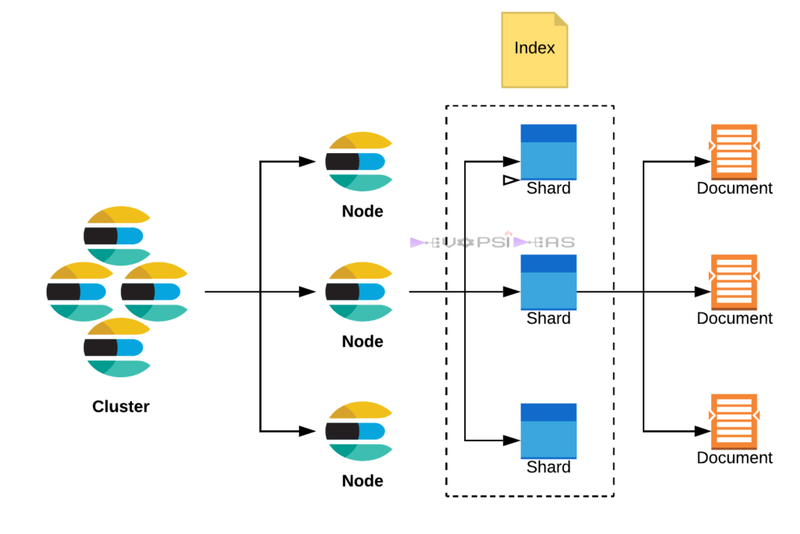
Elasticsearch 에서는 단일 데이터 단위를 도큐먼트(document) 라고 하며, 이 도큐먼트를 모아놓은 집합이 인덱스(Index, RDB database '같은' 개념)이다. 인덱스는 기본적으로 샤드(shard)라는 단위로 분리되고 각 노드에 분산되어 저장된다.
Cluster
Elasticsearch에서 가장 큰 시스템 단위, 최소 하나 이상의 노드로 이루어진 노드들의 집합 각 클러스터들은 독립적인 시스템으로, 서로의 데이터에 접근 및 교환할 수 없다. 여러 대의 서버가 하나의 클러스터를 구성할 수도 있고, 한 서버에 여러 개의 클러스터가 존재할 수도 있다.
Node
ES 클러스터를 구성하는 개별 서버로, 데이터를 저장하고 클러스터의 색인화 및 검색을 가능하는 역할을 수행한다. 각 노드는 고유한 name과 uuid를 가지고 있는데 이는 클러스터와 마찬가지로 노드를 식별하는 데 사용되는 요소로서 네트워크 내에 존재하는 특정 서버의 ES 프로세스가 현재 운영 중인 클러스터에서 어떤 역할을 담당하는지 식별한다. 또한 노드는 기본적으로 각각의 role이 존재하고 이 role에는 master, data을 비롯해 다양한 role들이 존재한다. 이 부분은 아래에서 자세히 다룬다.
Elasticsearch 기본 용어
하나의 Index는 복수의 Shard로 구성. Shard와 Index는 1:1로 맵핑된다.
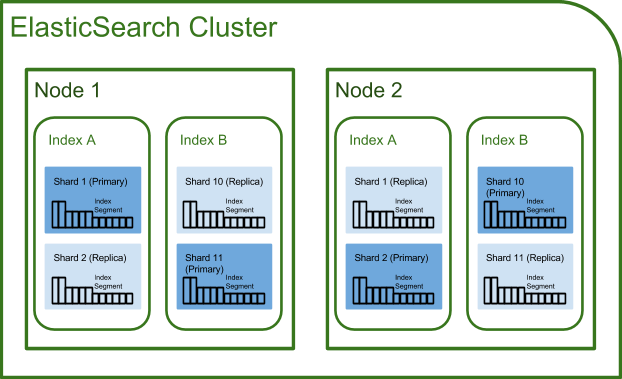
Index
데이터 저장 공간
하나의 물리 노드에 여러개 논리 인덱스 생성
하나의 인덱스가 여러 노드에 분산 저장 (M:N)
Shard
색인된 문서는 하나의 인덱스 — 인덱스 내부에 색인된 데이터는 여러개의 파티션으로 나뉘어 구성됨.
(파티션 = 샤드)
Type
인덱스의 논리적 구조
6.1부터 인덱스당 하나의 타입만 설정 가능(6.0 이하에서는 music 인덱스에서 rock, pop등 장르별로 분리하는데 타입을 사용할 수 있었음)
Document
데이터가 저장되는 최소 단위
JSON 포맷으로 저장
DB의 Row에 대응됨.
Field
문서를 구성하기 위한 속성
DB의 컬럼과 비교할 수 있음
하나의 필드는 목적에 따라 다수의 데이터 타입을 가질 수 있음
Mapping
문서의 필드, 필드 속성을 정의하고 그에 따른 색인 방법을 정의하는 프로세스
스키마 정의 프로세스라고 보면 된다.
Node Types
Master Node
1) 마스터 노드 (master-eligible node)
클러스터를 제어하는 마스터 노드. 반드시 path.data 디렉토리를 가져야 하며, 이 디렉토리는 클러스터의 메타데이터가 저장되어있다. 클러스터 메타데이터는 데이터 노드에서 어떻게 데이터를 읽을지에 대한 정보를 가지고 있다. 인덱스 생성과 삭제, 클러스터 노드들 추적 관리, 어떤 샤드가 어떤 노드에 들어가야할지를 결정한다.
2) 마스터 후보노드 (master-eligible node)
실제 메타데이터를 관리하는 마스터 노드는 한개이다. 마스터 노드 3개로 구성된 클러스터가 있다면, 나머지 두갠 마스터 후보 노드가 된다. 마스터노드와 마스터 후보 노드들이 항상 같은 메타 데이터를 유지해서 장애발생시 중단없는 서비스가 가능하다.
Data Node
실질적인 데이터 저장 : 데이터가 실제로 분산 저장되는 물리 공간인 샤드가 배치됨.
문서 색인 및 검색 요청 처리 : 색인 작업은 CPU, 메모리, 스토리 등 컴퓨팅 리소스를 많이 소요하므로 리소스 모니터링이 필요함.
Coordinating Node
cluster 에 요청이 오면 요청을 받은 노드가 coordinator 가 되어 어디로 요청을 보내야 할지 결정하고, 요청이 처리되어 받은 응답들을 합쳐 보내주는 역할.
클러스터 관련 요청은 마스터노드로, 데이터 관련 요청은 데이터 노드로 전달
검색 요청은 랜덤으로 shard를 선택하거나 preference 에 알맞은 노드의 샤드를 선택해서 처리하지만 색인 요청은 primary shard에만 요청이 간다.
Ingest Node
문서의 전처리(문서가 es 에 들어와서 저장되기 전에 수정되는 등..) 담당
인덱스 생성 전 문서의 형식을 다양하게 변경할 수 있음
Cluster, Node, Shard
하나의 ES 클러스터는 인덱스의 문서를 조회할 때 마스터 노드를 통해 2개의 노드를 모두 조회해서 각 데이터를 취합한 후 결과를 하나로 합쳐서 제공한다.
여러개의 클러스터를 연결해서 구성할 수도 있다. 클러스터 내 노드는 실시간으로 추가, 제거 가능하다.
아래는 인덱스별로 샤드가 2개고 리플리카가 1개로 설정한 예시이다.
{
"settings" : {
"index" : {
"number_of_shards" : 2,
"number_of_replicas" : 1
}
}
}
위의 설정값이 서버에 적용되면,
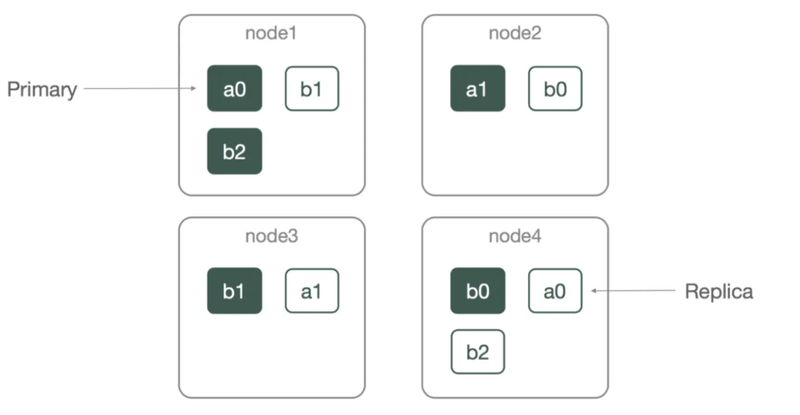
인덱스별로 샤드 2개, 리플리카 1개
초록색 네모는 Primary shard, 투명한 네모는 Replica.
a 인덱스를 예시로 보면, a0과 a1 두개의 shard로 구성되었으며, 이는 각각 node1과 node2에 저장.
a0과 a1 shard의 replica는 각각 다른 node인 node4와 node3에 저장.
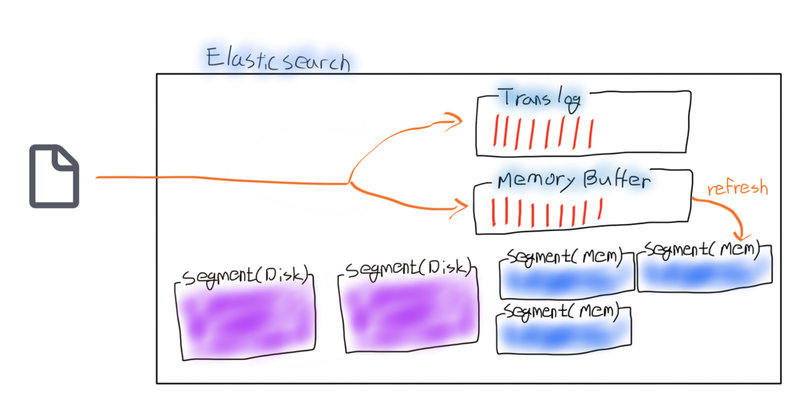
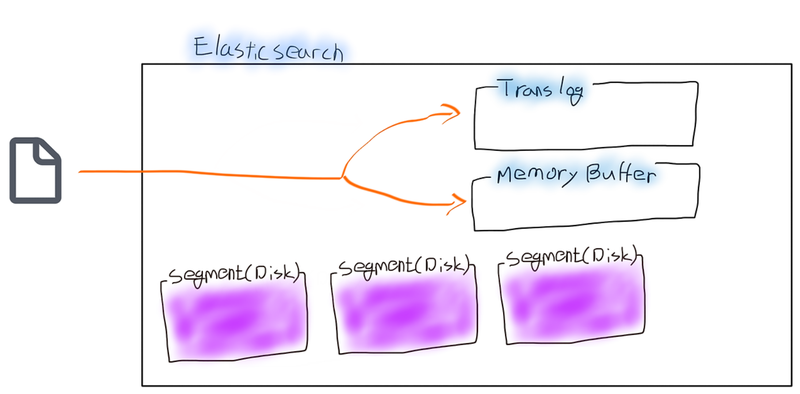
segment에 기록이 되지 않으면 검색되지 않는다. 위 그림에서 Memory Buffer에 있는 문서는 검색이 되지 않는다. (일반적으로 refresh_interval 간격으로 refresh가 실행되면 새로운 Segment(mem)이 생성되면서 Memory Buffer에 있는 내용이기록되고 검색이 된다.)
segment도 memory와 disk로 나뉘는데 만약 memory에만 기록된 상태에서 노드가 재시작되면 유실 된다.
memory에서 disk로 저장하는 연산인 Elasticsearch flush(Lucene commit)를 빈번하게 실행하자니비싼 연산이어서 자주 실행하기도 어렵다. 그래서 나온 개념이 translog(transaction log)다.
translog에는 색인 요청을 기록해서 나중에 복구할 때 사용한다. 물론 translog도 한 건 한 건 파일에 쓰는 게 아니라 유실이 있을 수 있지만 Elasticsearch flush보다 가벼워서파일에 빈번하게 쓸 수 있어 유실되는 양을 줄일 수 있다.
아래 그림은 flush 했을 때 translog와 segment를 나타낸 그림이다. segment(memory)를 합쳐 segment(disk)에 기록하는데Disk에 써져서 기존 Translog는 불필요해져서 기존 Translog는 지우고 새로운 Translog를 만든다.