1. Spring Data JPA
Spring Data JPA는, JPA를 쓰기 편하게 만들어 놓은 모듈이다.
스프링 부트로 개발하면, EntityManager를 직접 다룰 필요가 없어진다.
(순수 자바로 JPA를 사용한 예제👇🏻 )
스프링 부트에서는 DB에 접근할 필요가 있는 대부분의 상황에서는 Repository를 정의하여 사용한다.
이 Repository가 바로 Spring Data JPA의 핵심이다.
Spring Data JPA는 Spring에서 제공하는 모듈 중 하나로
개발자가 JPA를 더 쉽고 편하게 사용할 수 있도록 도와주는 일을 하는데,
이는 JPA를 한 단계 추상화시킨 Repository 라는 인터페이스를 제공함으로써 이루어진다.
사용자가 Repository 인터페이스에 정해진 규칙대로 메소드를 입력하면, 똑똑한 Spring이 알아서 해당 메소드 이름에 적합한 쿼리를 날리는 구현체를 만들어서 Bean으로 등록해주기 때문이다.
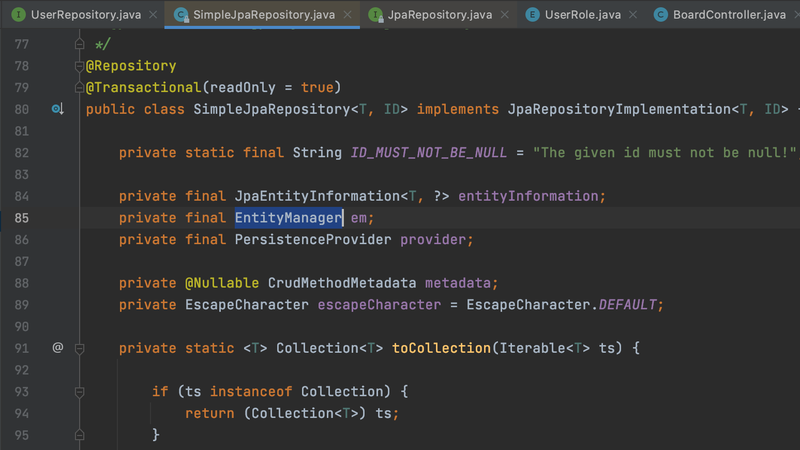
Spring Data JPA가 JPA를 추상화했다는 말은, Spring Data JPA의 Repository의 구현에서 JPA를 사용하고 있다는 것이다. 예를 들어, Repository 인터페이스의 기본 구현체인 SimpleJpaRepository의 코드를 보면 아래와 같이 내부적으로 EntityManager을 사용하고 있는 것을 볼 수 있다.
📍Spring Data JPA 용어 정리📍
|
Application | ||
|
Spring Data JPA (Repository) |
JPA를 쓰기 편하게 만들어 놓은 모듈. JPA를 한 단계 더 추상화 시킨 Repository라는 인터페이스가 Spring Data JPA 의 핵심! | |
|
JPA |
JPA 구성요소: (1) 엔티티 테이블과 직접적으로 매핑되는 클래스. (2) 레포지터리 엔티티 객체들을 처리하는 기능을 가진 인터페이스. | |
|
Hibernate |
JPA의 구현체. java.persistence.EntityManager과 같은 JPA의 인터페이스를 상속받고 각각 Impl로 구현한 라이브러리. | |
|
JDBC | ||
|
DB | ||
2. Spring Data JPA <-> DB
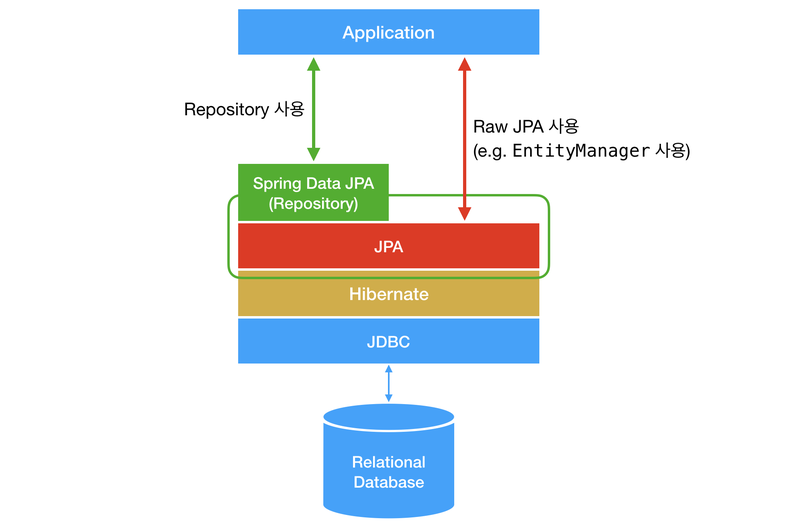
Spring Data JPA가 데이터를 다루는 과정.
Spring Data JPA가 DB에 데이터를 다루는 과정은 다음과 같다.
Spring Data JPA <-> Hibernate <-> JDBC <-> DB
3. Spring Data JPA 예제
우선 스트링부트 프로젝트 생성 시,
우측에 보이는 이 5가지를 추가한다.
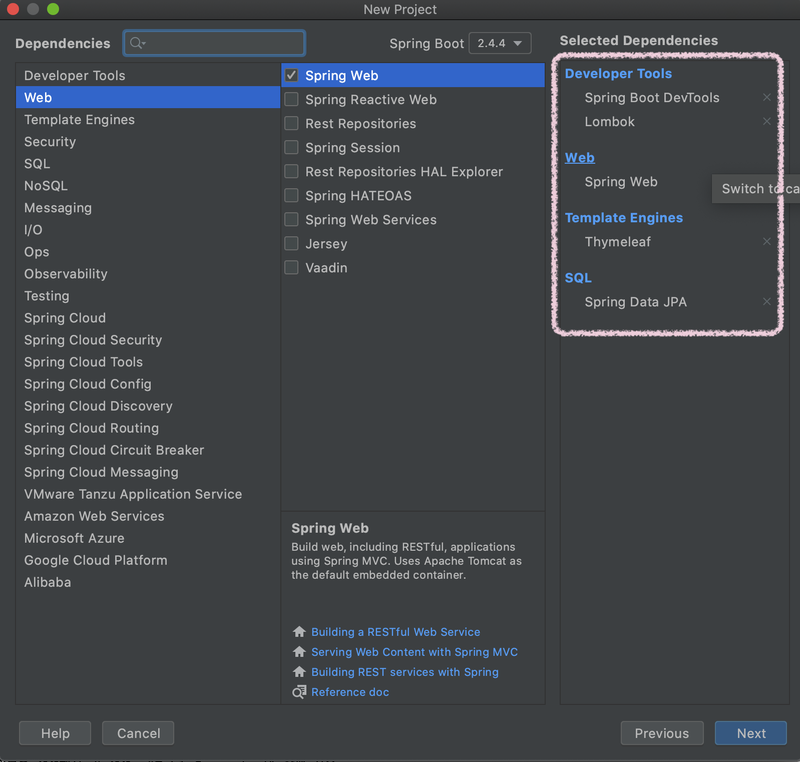
* 이따가 따로 추가할 거지만, 여기서 MySQL Driver을 추가해 두어도 좋다.
[ Next ]누르고 프로젝트 생성 후,
build Gradle 확인 :
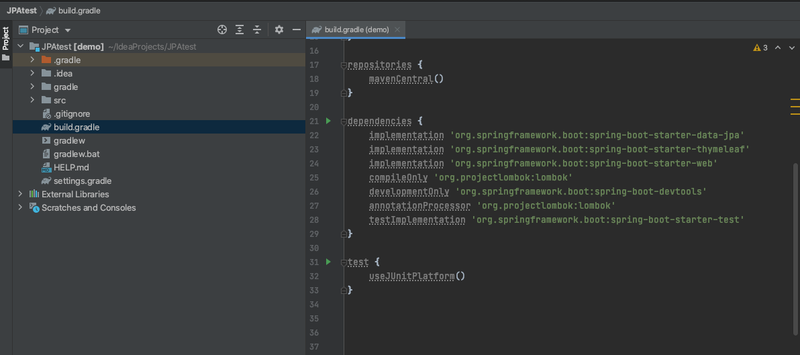
프로젝트가 생성된 후 확인하면
이렇게 5개가 추가되어 있다.
build Gradle에 mysql-connector-java 를 추가한다.
implementation group: 'mysql', name: 'mysql-connector-java', version: '8.0.23'
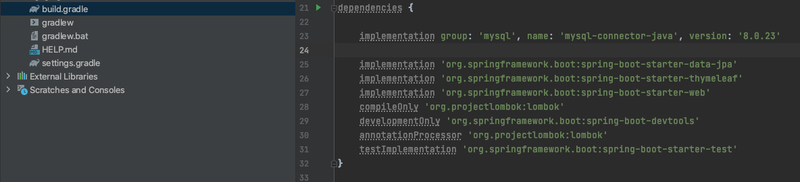
실행하면..
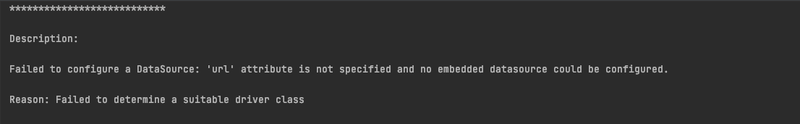
에러가 난다.😱
Failed to configure a DataSource: 'url' attribute is not specified and no embedded datasource could be configured.
mysql-connector는 추가 했는데, Url 이나 다른 설정들을 아직 안해줘서 그렇다.
스프링 부트 설정:
application.properties 파일에 설정한다.
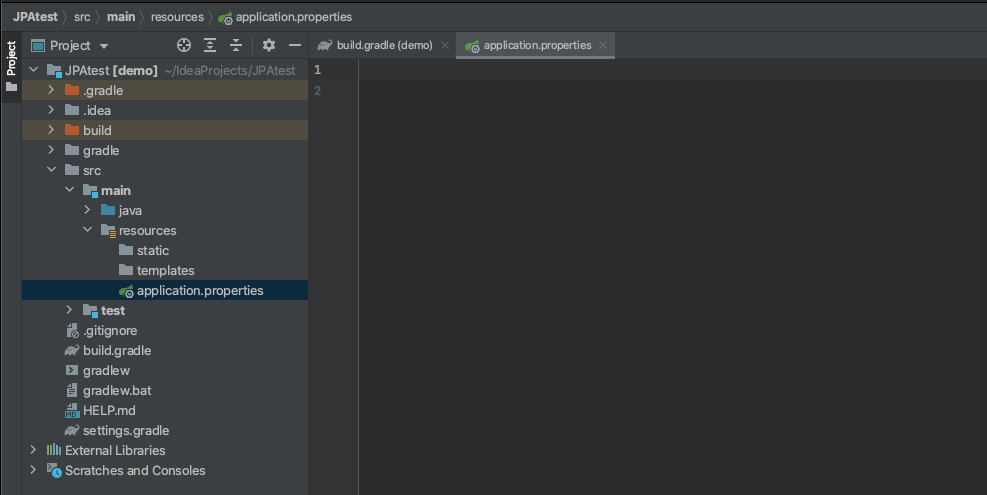
이 파일에 아래와 같이 4가지를 추가해 준다.
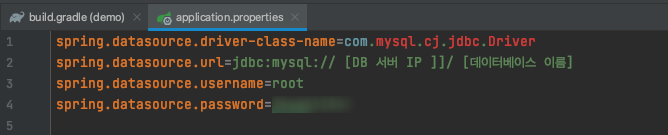
💡 소스코드를 복붙용:
spring.datasource.driver-class-name=com.mysql.cj.jdbc.Driver
spring.datasource.url=jdbc:mysql://
spring.datasource.username=
spring.datasource.password=
이렇게 추가해주고, 다시 실행하면 에러 없이 프로그램이 실행된다!
# Entity 구현
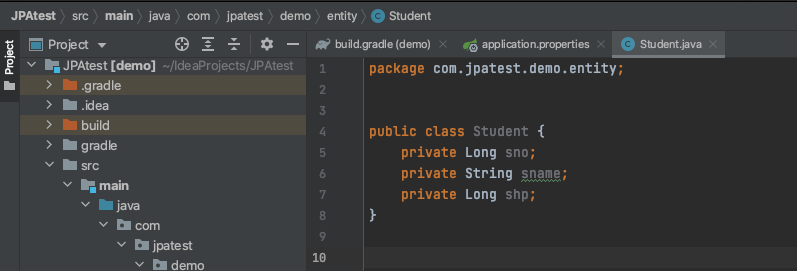
일단 전체 코드는 다음과 같다.
package com.jpatest.demo.entity;
import javax.persistence.*;

@Entity
@Table(name = "tbl_student")
public class Student {
    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
private Long sno;
private String sname;
private Long shp;
}
💡코드 설명:
1) @Entity
클래스에 지정, 해당 클래스가 엔티티 클래스라는 걸 명시 application.properties 파일에서 설정에 따라 테이블 생성도 가능.
2) @Table
엔티티 클래스를 DB의 어떤 테이블과 매핑시킬지 지정한다.
name 속성을 이용해서 특정 테이블의 이름을 지정.
ex) @Table(name="테이블이름")
* 지정 안해주면 자동으로 클래스 이름으로 테이블이 생성된다. 그치만 비추. :(
3) @Id
기본키에 해당하는 변수에 지정 엔티티 클래스에서 @Id로 지정한 변수가 없으면 에러 발생.

4) @GeneratedValue
사용자가 입력하는 값이 아닌 자동으로 생성되는 값을 사용할 때 사용.
타입
AUTO : 기본값, JPA 구현체가 알아서 생성
IDENTITY : 사용하는 DBMS가 키 생성을 결정, MySQL이나 MariaDB의 경우 auto_increment 사용, 오라클은 새로운 테이블을 생성해서 사용
SEQUENCE : DB의 sequence를 이용해서 키를 생성, @SequenceGenerator와 같이 사용
TABLE : 키 생성 전용 테이블을 생성해서 키 생성, @TableGenerator와 함께 사용
ex) @GeneratedValue(strategy = GenerationType.IDENTITY)
그리고 실행하기 전, application.properties 파일에 아래 3줄을 더 추가한다.
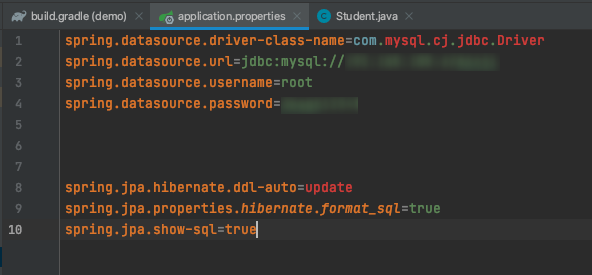
💡코드 설명:
8번 : 프로젝트 실행 시 자동으로 어떤 DDL을 생성할 것인지 지정.
(none: 아무것도 실행하지 않음.
create-drop : Session Factory가 시작될 때 drop, 생성을 실행하고 Session Factory가 종료될 때 drop을 실행.
create : 똑같은데, 차이점은 종료 시 drop을 하지 않는다는 것.
update : 스키마가 없으면, create하고 있으면, 수정한다.
validate : 변경된 스키마가 있다면 변경점을 출력하고 종료.)
9번 : SQL문을 그냥 좀 이뿌게 출력하게 하는 것..
10번 : SQL문을 출력.
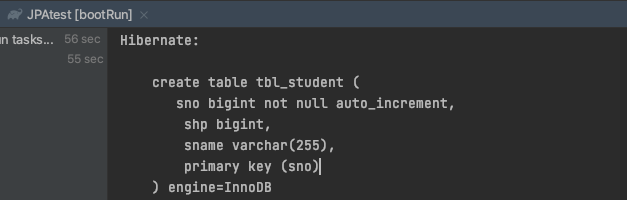
프로젝트 실행 전:
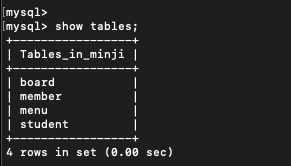
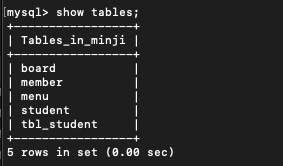
그리고 bootRun 해서 프로젝트 실행해서
테이블이 잘 추가 됐는지 확인해 본다.
# Repository
1) 구성
public interface 인터페이스이름 extends JpaRepository <엔티티클래스, @Id변수의 타입> {
}
2) 사용
상속을 받아 선언하는 것만으로 save(엔티티객체), findById(키 타입), getOne(키 타입), save(앤티티객체), deleteById(앤티티 객체) 메소드들을 통해서 CRUD 가능.
3) Repository 구현 예제
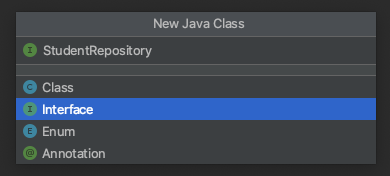
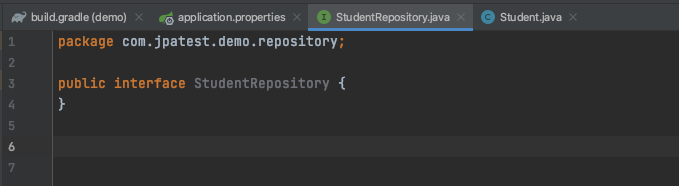
두근두근....
어떻게 구현하려나
package com.jpatest.demo.repository;
import com.jpatest.demo.entity.Student;
import org.springframework.data.jpa.repository.JpaRepository;
public interface StudentRepository extends JpaRepository<Student, Long> {
}
* <Student, Long>
// 주고받을 Entity 클래스 타입 지정,
                                     그 클래스 안에 @Id 어노테이션으로 지정한 변수의 타입 지정.
이것만 상속 받으면 끝!
ㅎㅎ 이렇게 상속만 받아오면 된다니 완전 간단해졌다.
이렇게 간단해진 이유는 처음에 설명한 것처럼,
사용자가 Repository 인터페이스에 정해진 규칙대로 메소드를 입력하면, 똑똑한 Spring이 알아서 해당 메소드 이름에 적합한 쿼리를 날리는 구현체를 만들어서 Bean으로 등록해주기 때문이다.
Repository 인터페이스의 기본 구현체인 SimpleJpaRepository의 코드. EntityManager을 사용하고 있는 것 확인.
이제 다음 포스팅에서,
이 레포지토리를 이용해 DB에 데이터를 CRUD 해보자!💪🏻