디지털 풍화는 왜 생길까?
Compress my cat to JPG
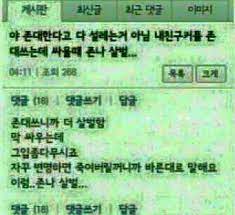
디지털 풍화.. 다들 뭔지 아시져..?
누가 쓴 글을 캡쳐해서 SNS에 올리고,
그걸 또 누가 캡쳐해서 커뮤니티에 올리고,
또 그걸 누가 캡쳐해서 썸네일로 쓰고..
이런식으로 한 이미지가 계속
인터넷 세상에서 돌아가다보면,
이렇게 너덜해진 '디지털 풍화' 작용이 일어난다.
이렇게 되는 이유는
우리가 이미지를 캡쳐하거나,
이미지를 플랫폼에 업로드할 때마다
자동으로 '압축'되는 이미지들이 있기 때문이다.
캡쳐+업로드+캡쳐+업로드 가 아니라
캡쳐+압축+업로드+캡쳐+압축+업로드
가 되는 것이기에
픽셀이 짜부되어 풍화 작용이 일어나는 것이다.
압축을 뭐 어떻게 하길래
내 소중한 이미지가 이래 너덜해지는 걸까!
이미지 압축의 핵심이자 첫 걸음,
'JPEG' 포맷에 대해 알아보자.
Joint Photographic Experts Group.
'JPEG'.
jpg, jpeg 확장자의 이미지 파일 형식
어쩌다가 이미지를 '압축'할 생각을 했을까?
이 jpeg이 만들어질 당시
1900년대 초반의 세상은 지금처럼 인터넷이 빠르지도,
저장공간이 넉넉하지도 않았다.
인터넷이 전화선 모뎀으로 연결되던 시절이었다.
이 시절 이미지 파일은 당연히 사치였는데,
그래서 컴공 똑똑 박사님들은 생각했다.
이미지 파일을 좀 줄일 수 없나?
어떤 부분을 줄일 수 있을까?
박사님들은 고민 끝에
어차피 사람 눈에 잘 안보이는 부분은 버려도 된다는
결론을 내렸다.
우리 눈은 사실
밝기에는 민감하고, 색상에는 둔감하다.
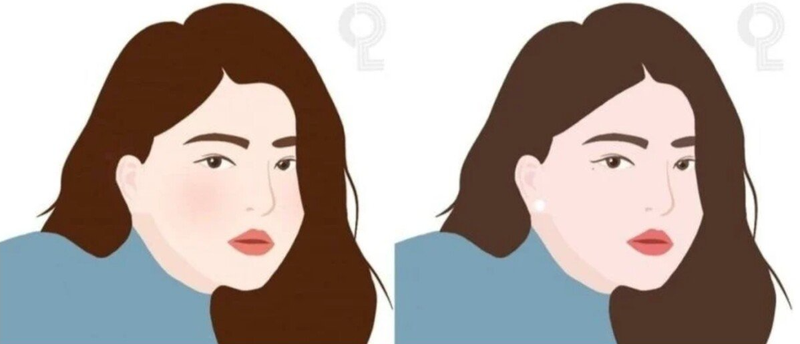
그리고 전체적인 틀이나 구조는 잘 보지만,
작은 디테일은 잘 알아차리지 못한다.
이 두 가지 사실을 박사님들은
이렇게 정리한다.
1. 밝기에는 민감하고, 색상에는 둔감하다
->
밝기 정보(Y)는 최대한 유지하고,
색상 정보(Cb, Cr)는 좀 뭉개도 되겠다.
이걸 '다운샘플링'기법을 통해
색상 정보를 절반 이하로 줄여버린다.
2. 저주파(전체 흐름)에는 민감하고,
고주파(디테일)에는 둔감하다.
->
이걸 DCT + 양자화 과정으로
눈에 잘 안 띄는 고주파 정보를 과감하게 버린다.
직접 jpeg 이미지를 압축 해봤다.
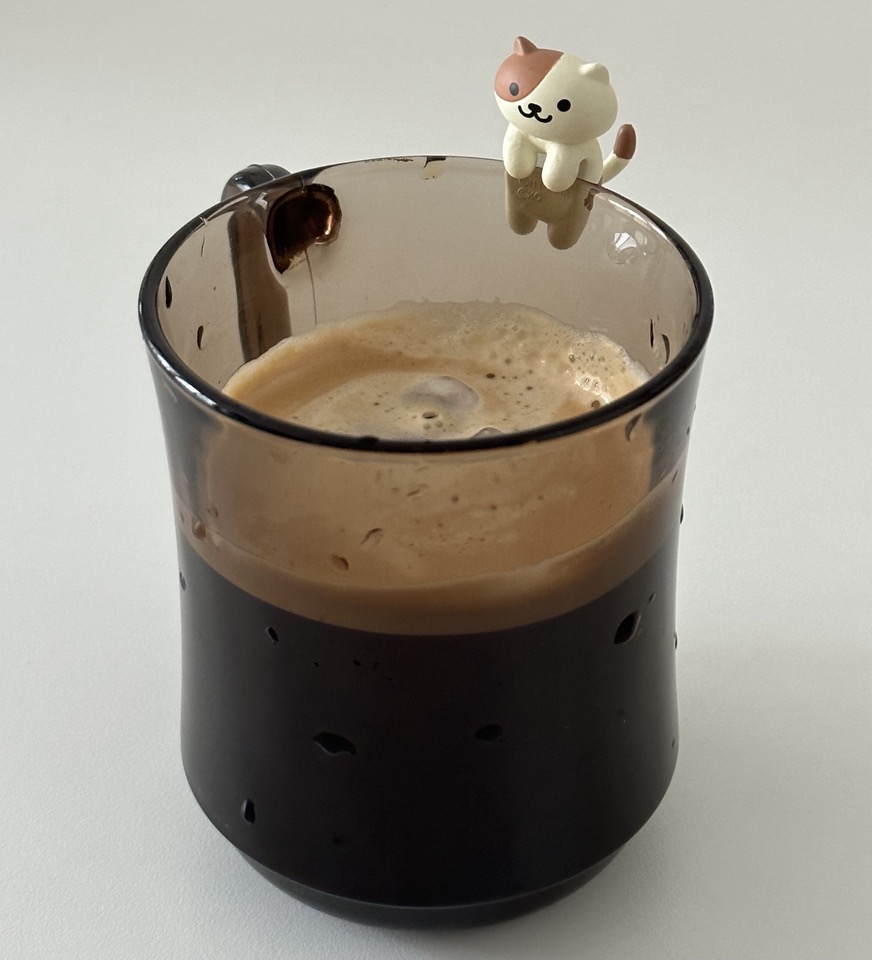
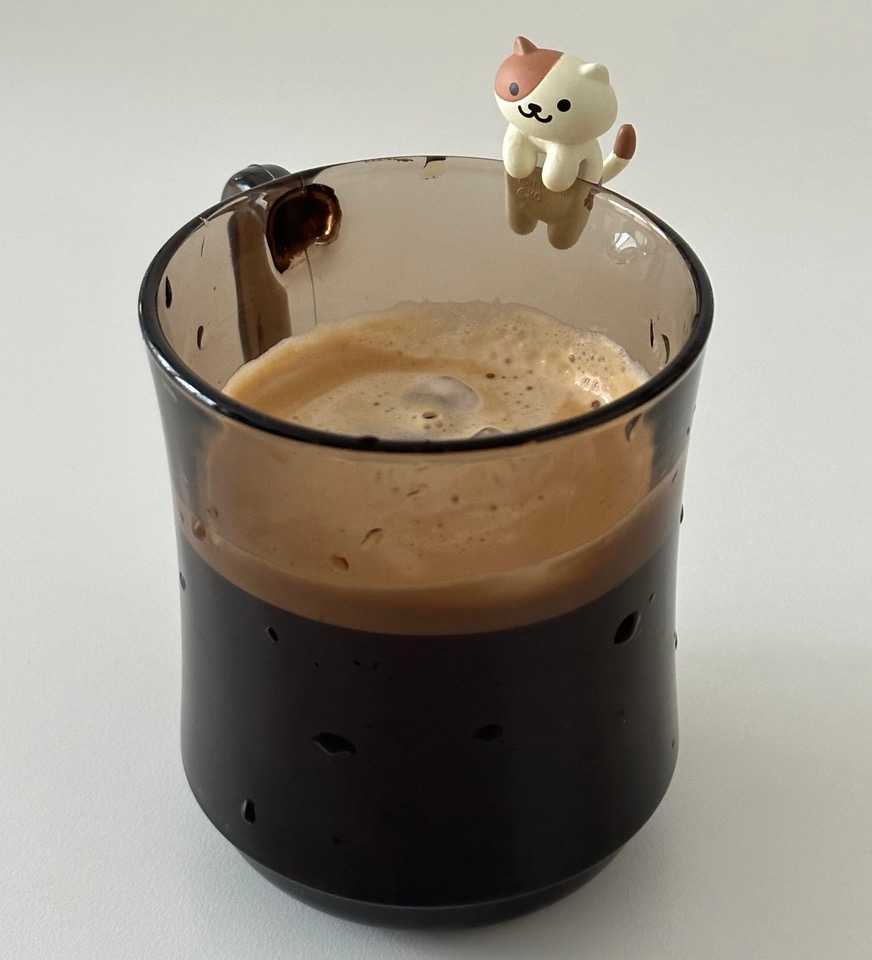
원본 이미지 vs 50% 압축 이미지
실제로 이미지 압축을 해보니,
압축한 티가 별로 안났다!
정말 버려도 되는 부분만 버린 것 같다.
그럼 도대체 어디를 어떻게 버린 건지
좀 더 자세히 알아보자.
JPEG 압축,
1. 색 공간 변환 (RGB → YCbCr)
2. 블록 분할 (8x8 Block Splitting)
3. DCT (이산 코사인 변환)
4. 양자화 (Quantization)
5. 지그재그 스캔 (Zigzag Scan)
6. DC / AC 계수 부호화
7. 허프만 인코딩 (Huffman Coding)
8. 최종 JPEG 스트림 생성
JPEG 파일은 위의 7단계를 통해 짜부된다.
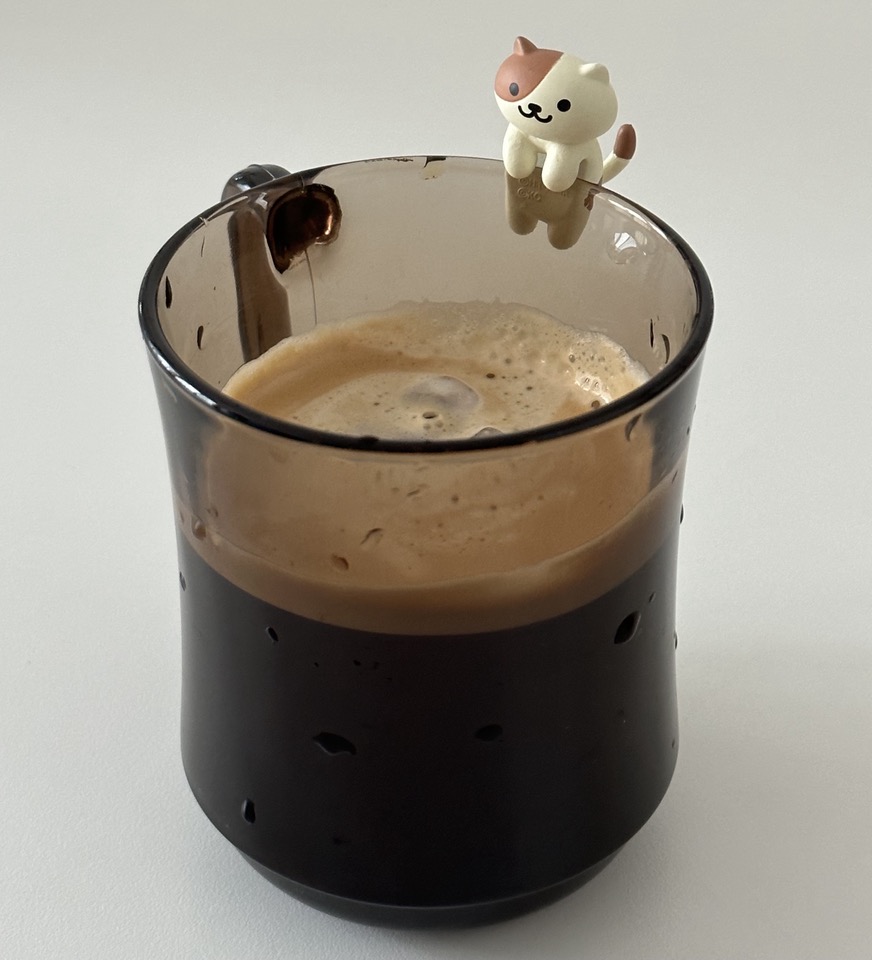
내 이미지 하나를 예시로
이 과정을 따라가 본다.
0. 이미지 준비
Sampling & Quantization
Sampling
JPEG 압축 전, 준비 운동.
실제 세상의 이미지는 연속적인 빛의 흐름이다.
이것을 컴퓨터가 이해할 수 있게
어떤 색을 가진 점, 즉 픽셀로 표현하는데 이것이 '샘플링'이다.
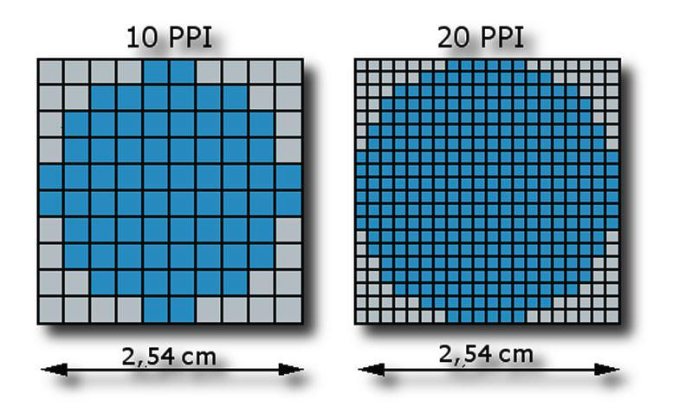
해상도가 높을수록, 표현되는 점(픽셀)의 수가 많아지고, 그만큼 이미지도 더 선명해진다.
샘플링으로 점을 찍었으면, 이제 그 점에 어떤 색이 들어 있는지 숫자로 표현한다.
RGB(빨, 초, 파) 각각 0~255 사이의 정수로 나타내서 색을 숫자로 정리하는 과정인데,
이를 디지털화(Digitization) 또는 넓은 의미에서의 초기 양자화(Quantization)라고 할 수 있다.
1. 색 공간 변환
RGB -> YCbCr
우리가 알고 있는 디지털 이미지는 기본적으로
RGB(빨강, 초록, 파랑) 세 가지 색으로 이루어져 있다.
(참고로 우리 눈에도 이 세 가지 색을 감지하는 세포가 존재한다. 적색, 녹색, 청색 빛에 반응하는 원추세포 세 종류가 있고, 이 덕분에 RGB처럼 색을 인식할 수 있다.)
JPEG은 압축을 더 잘하기 위해
이 색상 정보를 YCbCr이라는 방식으로 바꾼다.
왜냐하면, 우리 눈은 밝기 변화에는 민감하지만,
색상의 미세한 차이에는 둔감한 편이라
밝기(Y)정보는 잘 보여야 하니까 그대로 두고,
색상 정보(Cb, Cr)는 대~충 뭉쳐도 괜찮겠다 판단한 것이다.
YCbCr 방식
Y (Luminance): 밝기 정보
Cb: 파란색 성분과 밝기의 차이
Cr: 빨간색 성분과 밝기의 차이
예를 들어 4개의 픽셀이 있다고 가정했을때,
[ A ] [ B ]
[ C ] [ D ]
이 4픽셀의 색상(Cb, Cr)을 각각 따로 저장하지 않고,
이 4개를 평균내서 하나의 색상 값으로 묶어버리는 것이다. 이에 대해 다음과 같은 이점이 생긴다.
원래는 색상 정보가 4개 필요
다운샘플링하면 색상 정보는 1개만 저장
결과적으로 용량은 1/4로 줄어듬
이를 다운샘플링(downsampling) 또는,
더 정확하게는 크로마 서브샘플링(chroma subsampling)이라고 한다.
이 과정을 거친 내 고양이 이미지는 다음과 같다.
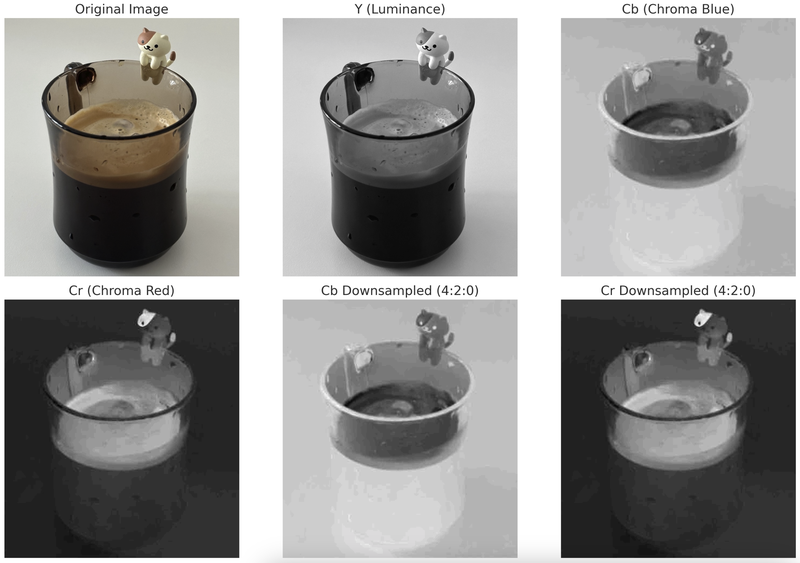
색 공간 변환 결과 (RGB → YCbCr)
좌상단: 원본 RGB 이미지
상단 중간: Y (밝기 정보. 해상도 유지되어야 함.)
상단 우측: Cb (원본. 파랑 - 밝기 차이)
하단 좌측: Cr (원본. 빨강 - 밝기 차이)
하단 중간, 우측: Cb, Cr를 각각 4:2:0 방식으로 다운샘플링한 결과
2. Block splitting (8x8)
엄밀히 말하자면 Y채널은 8x8 블럭으로,
CbCr채널은 다운샘플링 방식에 따라 각각 8x8(4:4:4), 16x8(4:2:2), 16x16(4:2:0)으로 분할.
이어서 Y, Cb, Cr 세 채널이 각각
8×8 블록 단위로 분할된다.
아래는 밝기 채널을 8x8 블록으로 분할한 결과다.
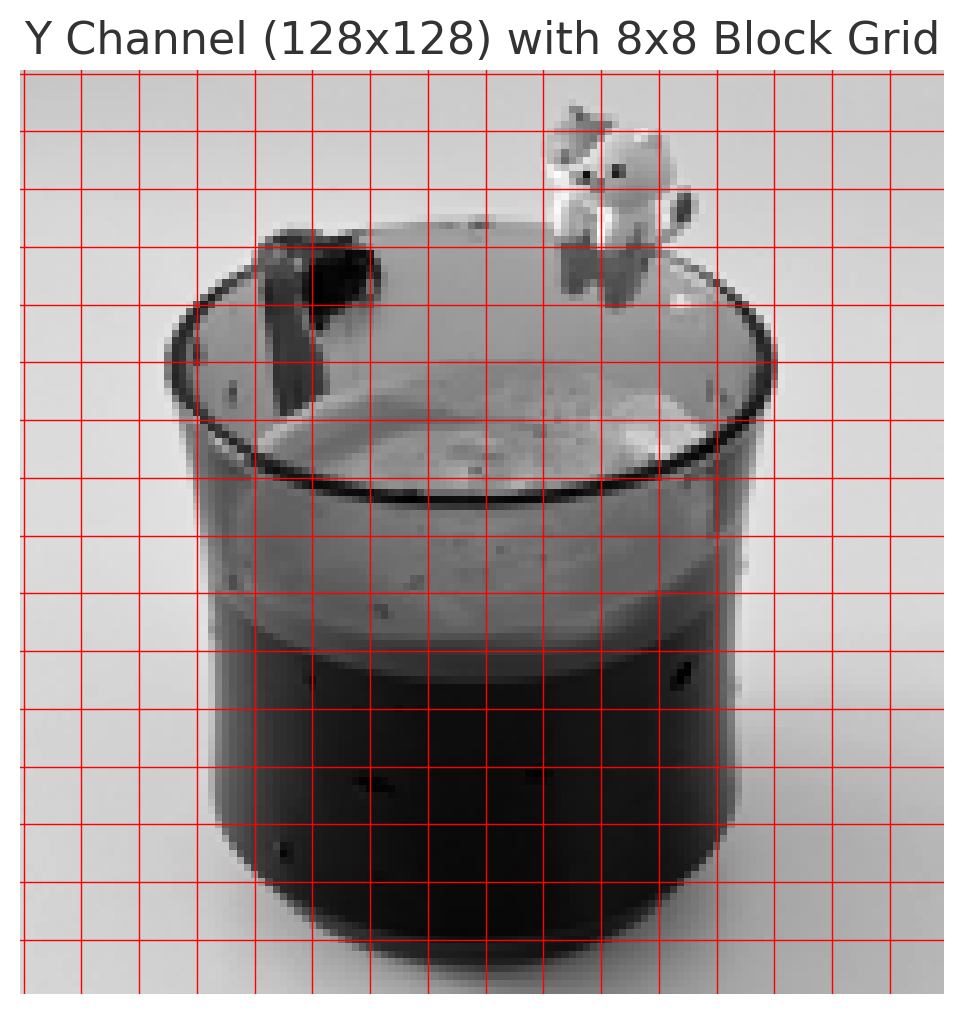
3. DCT (Discrete Cosine Transform)
이산 코사인 변환
분할된 블록 안의 밝기나 색상 값들을 숫자 패턴으로 바꿔주는 작업이다.
이것을 DCT (Discrete Cosine Transform), 이산 코사인 변환이라고 한다.
쉽게 말해, 음악도 악보를 보면 정말 복잡해 보여도
고음, 중음, 저음으로 나눌 수 있는 것처럼
이미지도 가로 줄무의, 세로 줄무늬, 땡땡이 패턴 등
기본적인 패턴 조각들로 바꾸는 것이다.
이걸 또 박사님들이 흔하게 사용되는 64개의 패턴 표를 미리 만들어놨다.
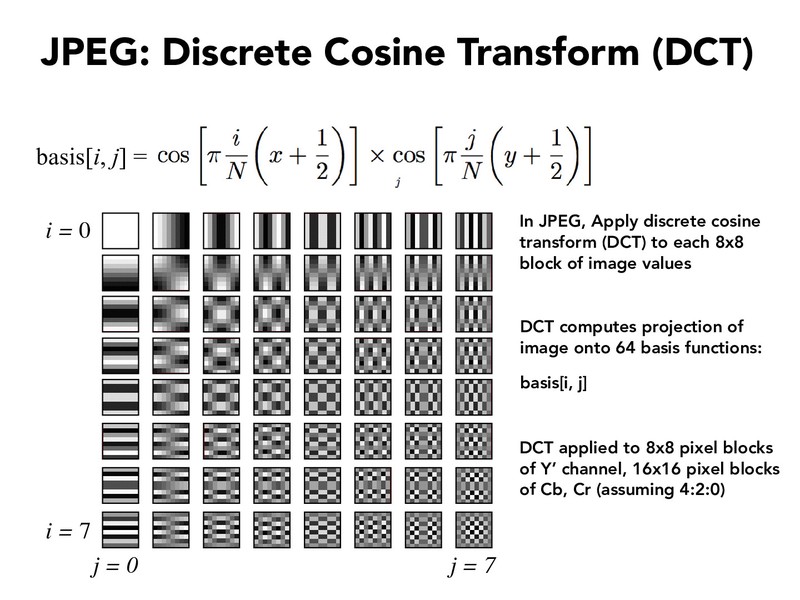
저 표는 DCT Basis Functions 라고 한다.
이 64개의 조각을
'얼마나 섞어야 이미지와 비슷하게 표현할 수 있을까?"를 계산하는 것이 바로 DCT 이고
그리고 '얼마나 섞어야'를 수치로 나타낸 것이 계수(coefficient)다.
DCT 과정
① [0~255] 범위: 원본 밝기값
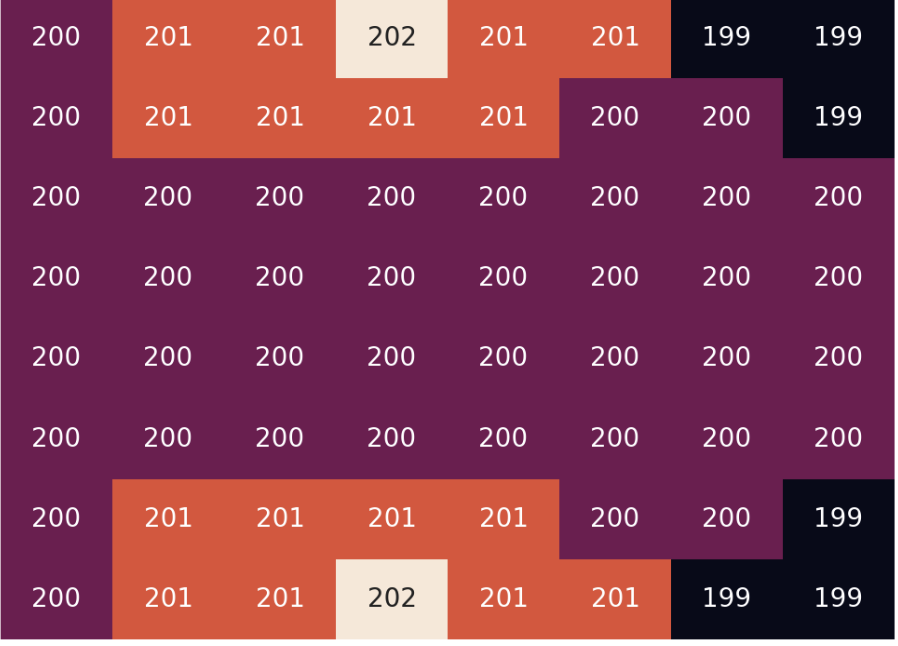
왼쪽의 [0, 255] 범위는 원본 이미지의 밝기 값이다.
각각의 숫자는 8x8 블록 안의 픽셀 밝기를 의미한다.
② -128을 빼줌 (중앙 정렬)
JPEG에서는 계산을 좀 더 효율적으로 하기 위해,
모든 숫자에서 128을 빼서 -128~127 사이 값으로 바꾼다.
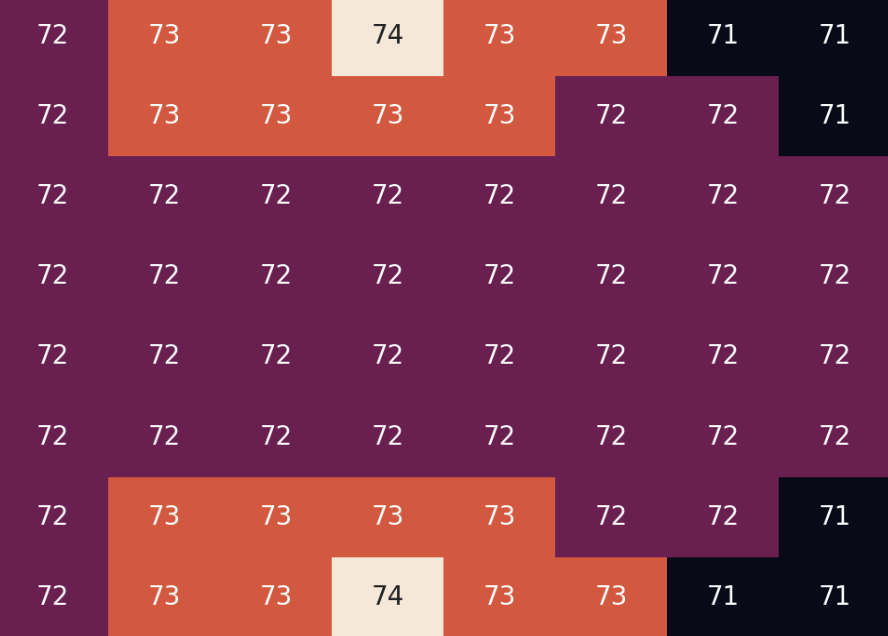
이걸 하면 밝기가 중간값(0)을 중심으로 퍼지게 된다.
밝은 건 양수, 어두운 건 음수로 나타남.
③ DCT (이산 코사인 변환)
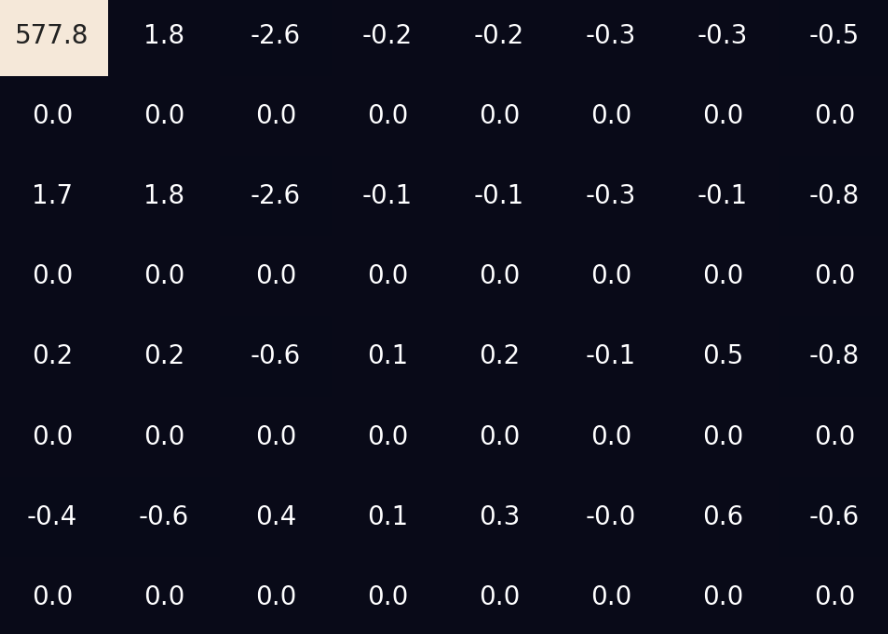
이제 이 숫자 덩어리를 수학적으로 주파수 성분으로 쪼갠다.
이때 각 패턴이 얼마나 섞여 있는지를 숫자(계수)로 표현하는데,
가장 왼쪽 위에 있는 DC 계수는 블록 전체의 평균 밝기와 관련된 저주파 성분이다.
나머지 63개의 AC 계수는 고양이 귀의 경계선이나 커피 거품의 결처럼 세부적인 디테일(고주파)을 나타낸다.
이 사람 눈이 잘 못 느끼는 고주파 성분(AC 계수)을 줄이거나 생략함으로써, 파일 크기를 줄이는 것이 Jpeg 이미지 압축의 핵심 원리다.
4. 양자화 (Quantization)
파일 크기를 줄이기 위해,
'중요하지 않은 세부 정보'를 버리는 것!
양자화는 DCT 변환을 통해 얻은 64개의 계수들(주파수별 세기)를 좀 더 적은 정보로 저장하기 위해
64개의 계수를 미리 정해진 양자화 테이블의 값으로 나눠준 뒤 반올림하여
비교적 중요하지 않은 고주파 성분은 대부분 0으로 만들고, 중요한 정보만 남기는 과정이다.
위에서 구한 DCT 계수 블록:
[ 577.8, 1.8, -2.6, -0.2, -0.2, -0.3, -0.3, -0.5 ],
[ 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0 ],
[ 1.7, 1.8, -2.6, -0.1, -0.1, -0.3, -0.1, -0.8 ],
[ 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0 ],
[ 0.2, 0.2, -0.6, 0.1, 0.2, -0.1, 0.5, -0.8 ],
[ 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0 ],
[ -0.4, -0.6, 0.4, 0.1, 0.3, -0.0, 0.6, -0.6 ],
[ 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0 ]
JPEG 표준 양자화 행렬 예시 (품질 50 기준):
[ 16, 11, 10, 16, 24, 40, 51, 61 ],
[ 12, 12, 14, 19, 26, 58, 60, 55 ],
[ 14, 13, 16, 24, 40, 57, 69, 56 ],
[ 14, 17, 22, 29, 51, 87, 80, 62 ],
[ 18, 22, 37, 56, 68, 109, 103, 77 ],
[ 24, 35, 55, 64, 81, 104, 113, 92 ],
[ 49, 64, 78, 87,103, 121, 120, 101 ],
[ 72, 92, 95, 98,112, 100, 103, 99 ]
양자화 수행 방법:
양자화 계수 = DCT 계수 ÷ 양자화 행렬의 값 → 반올림
이 계산을 거치면 다음고 같은 결과가 나온다.
[ 36, 0, 0, 0, 0, 0, 0, 0 ],
[ 0, 0, 0, 0, 0, 0, 0, 0 ],
[ 0, 0, 0, 0, 0, 0, 0, 0 ],
[ 0, 0, 0, 0, 0, 0, 0, 0 ],
[ 0, 0, 0, 0, 0, 0, 0, 0 ],
[ 0, 0, 0, 0, 0, 0, 0, 0 ],
[ 0, 0, 0, 0, 0, 0, 0, 0 ],
[ 0, 0, 0, 0, 0, 0, 0, 0 ]
오. DC 계수 하나(36)만 남고 나머지는 모두 0이 됐다.
덜 중요한 부분을 효율적으로 줄인 것이다.
압축률을 높이고 싶다면 양자화 테이블의 값을 더욱 크게 하면 되고, 압축률을 줄이는 대신 이미지 품질을 높이고 싶다면 양자화 테이블의 값을 줄이면 된다.
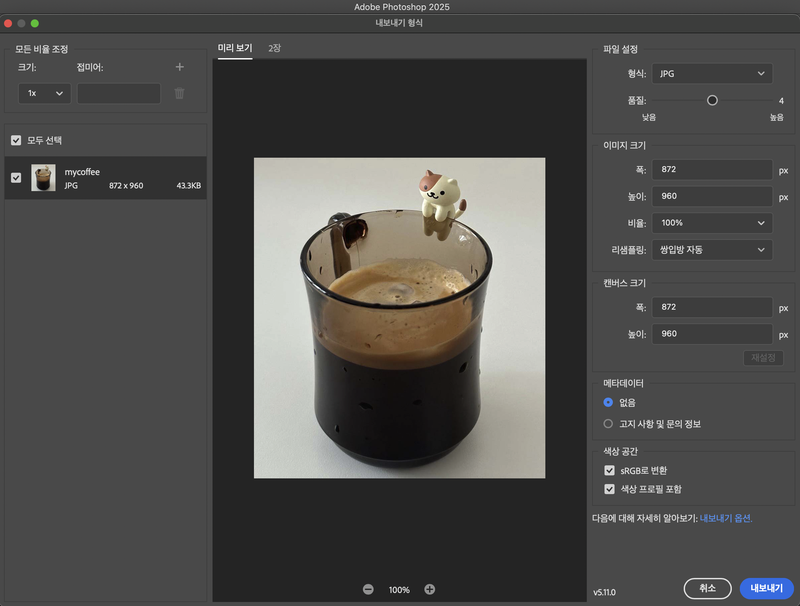
참고로 포토샵에서 JPEG 로 이미지 내보내기 시
이 '품질 값'슬라이더가 Quantization Table 이다.
품질이 낮을수록 Quantization table이 커져서
더 많은 주파수 계수를 0으로 만들고, 고주파 정보가 날아가는 원리다.
5. zigzag 스캐닝
1차원 리스트로 스캐닝.
위의 64개의 양자화된 2차원 배열 값을
지그재그 순서로 1차원 배열(리스트)로 변환하는 과정이다.
지그재그 순서로 나열하는 이유는, 그렇다.
왼쪽 위 저주파부터 시작해서
가장 오른쪽 하단의 고주파로 끝나게 하기 위해서이다.
[36, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0]
나의 경우, 깔끔하게도 제일 첫번째를 제외한 모든 정보가 0이 나왔는데, 보통 지그재그로 나열하면 앞쪽은 숫자, 뒤쪽은 0 이 잔뜩나온다.
0이 연속되니 압축 효율이 높아지는 것이다.
0이 연속되는게
왜 압축 효율이 높아지는 거냐면...
6. 부호화
나 진짜(x10) 배고파
부호화(Encoding는 정보를 더 적은 비트(bit)로 표현해서 공간을 절약하고 전송을 빠르게 하기 위한 과정이다.
내 경우, 이미지를 줄인다고 줄였는데도 아직
36, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0...
이렇게나 중복된 숫자가 많다.
이럴땐 그냥 36 한번, 0 20번. 이렇게 줄이면 좋은데,
이 방식이 바로 런렝스 부호화(Run-Length Encoding)이다.
그런데 DC계수 부호화와 AC 계수 부호화의 차이가 있다.
1. DC 계수 부호화:
차분 부호화 (Differential Encoding)
DC 계수는 각 블록의 전체 밝기 평균을 나타내는 값이라고 했다. 이 값은 보통 인접한 블록끼리 큰 차이가 나지 않기 때문에, 각 블록의 DC 값을 그냥 저장하는 것보다,
"이전 블록보다 얼마나 밝아졌는지(혹은 어두워졌는지)" 를 저장하면 훨씬 숫자가 작고, 효율적으로 표현할 수 있다.
예시:
블록1의 DC: 100
블록2의 DC: 104
저장할 값은: 104 - 100 = 4
이 "차이" 값만 저장!
그리고, 저장 시 이 차이 값을 범주(Category)로 한번 더 분류한다. 예를들어 4는 이진수로 100, 즉 3비트로 표현리 가능하다.
그렇다면 Category 3로 분류!
그리고 이 Category 번호를 '허프만 코드'로 한번 더 바꿔서 저장한다.
JPEG 표준에는 각 Category에 해당하는 DC 허프만 코드가 정의되어 있는데, Category 3의 경우 보통 100으로 표현된다.
(단, 실제 JPEG 파일 내에서는 별도의 DHT 세그먼트를 통해 커스텀 허프만 테이블을 사용하는 경우도 있다.)
그렇다면
허프만 코드의 Category 3 = 100
실제 값인 4 = 100
최종적으로 저장되는 DC정보 저장 값은
100100 이 되는 것이다.
1. 이전 DC 계수와의 차이값 계산
2. Category 구함 (몇 비트로 표현 가능한가?)
3. Category 번호를 허프만 코드로 인코딩
4. 실제 차이값을 2진수로 표현해서 붙임
복잡함 ;
2. AC 계수 부호화:
Run-Length + 허프만 부호화
AC 계수는 DC 계수와 달리 고주파 정보(디테일)를 담고 있다. 하지만 대부분은 값이 0입니다.
압축하면서 고주파 정보(눈에 잘 안 보이는 디테일)를 대부분 버려도 티가 잘 안 나기 때문이다,
그래서 JPEG에서는 AC 계수를 효율적으로 저장하기 위해
"0이 몇 번 반복됐는지 + 0이 아닌 값"의 쌍으로 압축해버린다. 이 방식을 런렝스 인코딩(Run-Length Encoding, RLE) 이라고한다.
설명에 앞서 내 예시를
아래와 같이 살짝 다듬어 본다 ^^;
[36, 0, 0, 0, 2, 0, 0, -1, 0, 0, 0, 0, 1, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0]
36 1개, 나머지 0은 너무 극단적이라..
역시 AC 계수는 대부분 0이고,
의미 있는 값은 몇 개 안된다.
내 경우 다음과 같이 정리할 수 있다.
|
인덱스 범위 |
값 |
설명 |
결과 쌍 |
|
1 |
0 |
0개 0 뒤에 36 (DC는 제외) |
(0, 36) ← 생략 |
|
2~4 |
0 |
3개 0 뒤에 2 |
(3, 2) |
|
5~6 |
0 |
2개 0 뒤에 -1 |
(2, -1) |
|
8~11 |
0 |
4개 0 뒤에 1 |
(4, 1) |
|
이후 |
0 |
전부 0 → 종료 신호 |
(EOB) 남은 값이 전부 0이면, 그냥 "여기까지 다 0입니다!" 한 줄로 표현한다. |
이걸 간단하게 다음처럼 정리할 수 있다.
[
(3, 2),
(2, -1),
(4, 1),
(EOB)
]
이것을 또 어덯게 저장하냐면,
1. (ZeroCount, Value) -> Category 계산
양수/음수 상관없이 절댓값 기준으로 계산한다.
2 → 양수, 2비트 필요 → Category 2
-1 → 음수, 1비트 필요 → Category 1
1 → 양수, 1비트 필요 → Category 1
2. (ZeroCount, Category) 조합 ->
AC 허프만 코드.
허프만 코드는 JPEG 표준 테이블에서 나온 예시
JPEG에서 AC 계수는 (ZeroRunLength, Category) 형태로 묶여 허프만 테이블을 참조한다.
Category는 해당 값의 크기(절댓값 기준)를 몇 비트로 표현할 수 있는지를 나타내며,
허프만 테이블은 (ZeroRunLength, Category) 조합에 대응되는 코드를 제공한다.
그 다음, 실제 값은 Category 길이만큼의 이진수로 표현되는데
양수는 일반 이진수 그대로 사용하고,
음수는 양수 표현값에 대해 가장 큰 값에서 역으로 매핑한다.
(3, 2) → 11100
(2, 1) → 1100
(4, 1) → 11101
(0, 0) → 1010 (EOB)
3. 뒤에 실제 값의 이진 표현을 붙임
Category가 2면, 2비트로 값을 이진수 표현한다.
이 때 양수는 그대로 표현하고,
음수는 보수 표현 (category 길이만큼의 비트) 으로 나타내되, 부호 없는 이진수 중 가장 큰 수부터 역순으로 대응시킨다.
Category 2 (2비트):
양수 1 → 01
양수 2 → 10
음수 -1 → 00
음수 -2 → 11

Category 1 (1비트):
양수 1 → 1
음수 -1 → 0
그래서 최종 적으로는 다음처럼 정리가 되고,
|
(ZeroRun, Value) |
Category |
Huffman Code |
Value Bits |
|
(3, 2) |
2 |
11100 |
10 |
|
(2, -1) |
1 |
1100 |
0 |
|
(4, 1) |
1 |
11101 |
1 |
|
EOB |
- |
1010 |
- |
최종 인코딩 결과 (비트 스트림)는 다음과 같다.
11100 10 1100 0 11101 1 1010
이것이 내 이미지의 한 8×8 블록의 AC 계수 부호화 결과가 되는 것이다.
이제 좀 전에 저장한 DC와 이 AC를 더하면 끝난다.
7. 최종 JPEG 스트림 생성
마지막_최종_진짜최종_last.jpg
이렇게 도출된 각 블록의 DC + AC 스트림을 이어붙인다.
DC (차이값 4): 100 (허프만) + 100 (값 비트)
AC: 11100 10 1100 0 11101 1 1010
-> 100100111001011100011010
이게 한 블록이다.ㅋㅋ
모든 블록에 아래 과정을 반복한다.
1. 각 블록의 DC 계수 →
차분값 계산 + 허프만 부호화 + 값 비트
2. 각 블록의 AC 계수 →
런렝스 + 허프만 부호화 + 값 비트
3. 이를 순서대로 이어붙임
4. 이 과정을 Y, Cb, Cr 각 채널에 대해 블록 단위로 반복.
이것이 보여 모든 블록의 DC, AC를 차례대로 이어붙이면, 하나의 거대한 비트 스트림이 생성된다.
이 거대한 비트스트림은
그냥 텍스트가 아니라, JPEG 포맷 구조에 맞게 다양한 헤더, 세그먼트와 함께 저장된다.
JPEG 파일 구조
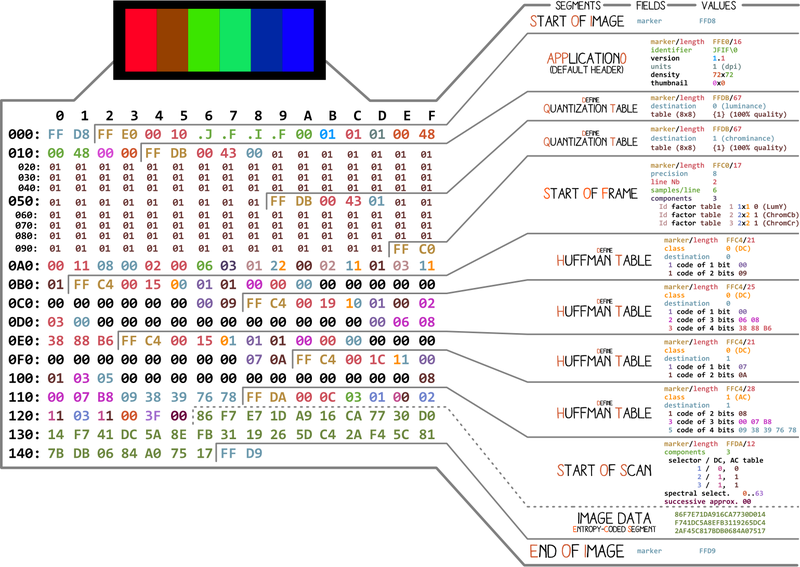
|
세그먼트 |
설명 |
|
SOI (Start of Image) |
파일 시작 (0xFFD8) |
|
APP0 (JFIF 등) |
파일 식별자 (0xFFE0) |
|
DQT |
Quantization Table (양자화 테이블 정보) |
|
SOF0 |
이미지 크기, 컬러 구성 (Baseline DCT용) |
|
DHT |
Huffman Table (DC, AC용 허프만 테이블) |
|
SOS |
Start of Scan – 이제부터 본격 이미지 데이터 |
|
압축 데이터 |
위에서 만든 DC+AC 부호화 비트스트림 |
|
EOI (End of Image) |
파일 끝 (0xFFD9) |
JPEG 파일 구조에 대해서는
구글에 'jpeg file format structure'라고 검색하면
글로벌 인재들이 정리한 JPEG 파일 구조 정보를 무료로 얻어갈 수 있다.
이렇게 "디지털 풍화는 왜 되는 걸까?" 라는 호기심에서 시작해 JPEG 이미지 포맷의 압축 과정을 하나하나 따라가 봤다.
결국 JPEG라는 이미지 파일 자체가
처음부터 손실 압축 방식이기 때문에,
저장하는 순간부터 정보 일부가 짜부된다.(사라진다)
그리고 이 과정을 반복하다 보면
우리가 흔히 말하는 디지털 풍화 현상이 생기는 것이다.
만약 원본 그대로의 품질을 유지하고 싶다면,
PNG나 BMP처럼 무손실 압축 방식의 포맷을 사용하는 것이 훨씬 더 적절하다.
ㅎ 이렇게 말하니 또 무손실 압축 방법이
너무 궁금해 지지 않는가..
이건 좀 더 알아보고 정리해 봐야겠다.
p.s.
이미지 파일 압축 관련 프로그램을 만들며
알게된 정보를 정리해 봤다.
이미지를 이렇게까지 알고 싶진 않았지만. 흥미롭긴하다.
학부생때 배웠던 것들이 꽤 나왔는데
그땐 내 인생에 쓸모없는 지식이라 생각했었다.
보통 퓨리에 변환이 인생에 쓸모있을거라 생각은 안하지..
아무튼 이렇게 묵혀있던 글 하나를 발행해본다.
틀린 부분이 있다면
댓글로 알려주세요 ~~ 👼🏻