이전 글
페이징을 하면서 컬렉션 엔티티를 같이 조회하려면 어떻게 해야할까?
XToOne 관계는 모두 fetch join. (toOne 끼리는 fetch join을 해도 문제없음. 데이터 row수가 변하지 않음.)
컬렉션 조회는 지연로딩으로. 여기서 지연 로딩 성능 최적화를 위해, @BatchSize 혹은 hibernate.default_batch_fetch_size 옵션을 사용한다. (후자는 글로벌/전자는 특정 엔티티에만) 적어둔 갯수만큼 미리 땡겨오는 녀석이다.
[OrderController]
    @GetMapping("/orders")
public List<OrderDto> orders() {

        List<Order> orders = orderRepository.findAllWithMemberDelivery();
        List<OrderDto> result = orders.stream()
.map(o -> new OrderDto(o))
.collect(toList());
return result;
}
[OrderRepository]
 public List<Order> findAllWithMemberDelivery() {
return em.createQuery(
"select o from Order o" +
" join fetch o.member m" +
" join fetch o.delivery d", Order.class)
.getResultList();
}
위에서 설명했듯이, XToOne 관계인 member와 delivery는 그냥 페치조인으로 가져온다. 하지만 orderItems는 ToOne 관계가 아니라 페치조인을 하면 성능최적화가 불가능 하다.
모든 쿼리문을 보기엔 너무 길어서 이 한 장만 첨부했지만 굉장히 길고 N+1 문제가 생긴 상황이다.
해결해보자..
@GetMapping("/orders")
public List<OrderDto> orders(@RequestParam(value = "offset", defaultValue = "0") int offset,
                                        @RequestParam(value = "limit", defaultValue = "100") int limit) {

        List<Order> orders = orderRepository.findAllWithMemberDelivery(offset, limit);
        List<OrderDto> result = orders.stream()
.map(o -> new OrderDto(o))
.collect(toList());
return result;
}
offset limit 옵션을 주고, repository에 이 파라미터를 받게 구현한다.
public List<Order> findAllWithMemberDelivery(int offset, int limit) {
return em.createQuery(
"select o from Order o" +
" join fetch o.member m" +
" join fetch o.delivery d", Order.class)
.setFirstResult(offset)
.setMaxResults(limit)
.getResultList();
}
그리고 yml 파일에 다음과 같이 default_batch_fetch_size: 100 를 추가한다.
jpa:
hibernate:
      ddl-auto: create
    properties:
hibernate:
show_sql: true
format_sql: true
default_batch_fetch_size: 100
여기서 100으로 설정해둔 부분이 in 쿼리의 갯수를 정하는 건데,
여기를 10으로 해두고 총 데이터 수가 100개면 10개 날아가는 식이다.
(일단 이는 global하게 설정하는 방법이고, 엔티티에 @BatchSize(size=[]) 옵션을 주면 더 세세하게 설정할 수 있다.)
api를 호출해서 결과를 확인해보자.
http://localhost:8080/orders?offset=0&limit=100
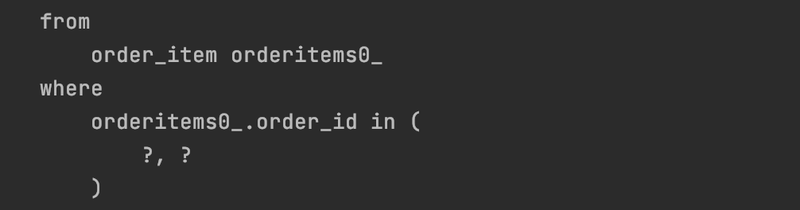
결과 쿼리가 굉장히 짧아진 것을 확인할 수 있다!
이 전 쿼리는 멤버 각각 쿼리를 날렸는데 지금은 in 쿼리로 한번에 날려서 가지고 온다.
그리고 product도 한번에 4개를 다 가져온다. 이게 지금은 4개지만, 100개라면? ^^ 대박!
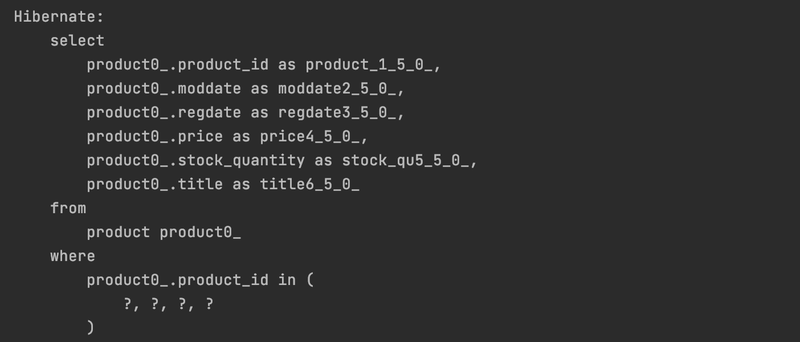
그래서 이렇게 하면 1:M:N 이 1:1:1이 되는 최적화가 가능한 것이다.
그런데, 사실 쿼리 수만 따져보면 한번에 조회됐던 모두 fetch join한 버전이 쿼리 1번으로 가장 적긴하다.
하지만 뽑은 데이터만 살펴보면 중복된 데이터가 많다는 문제가 있다.
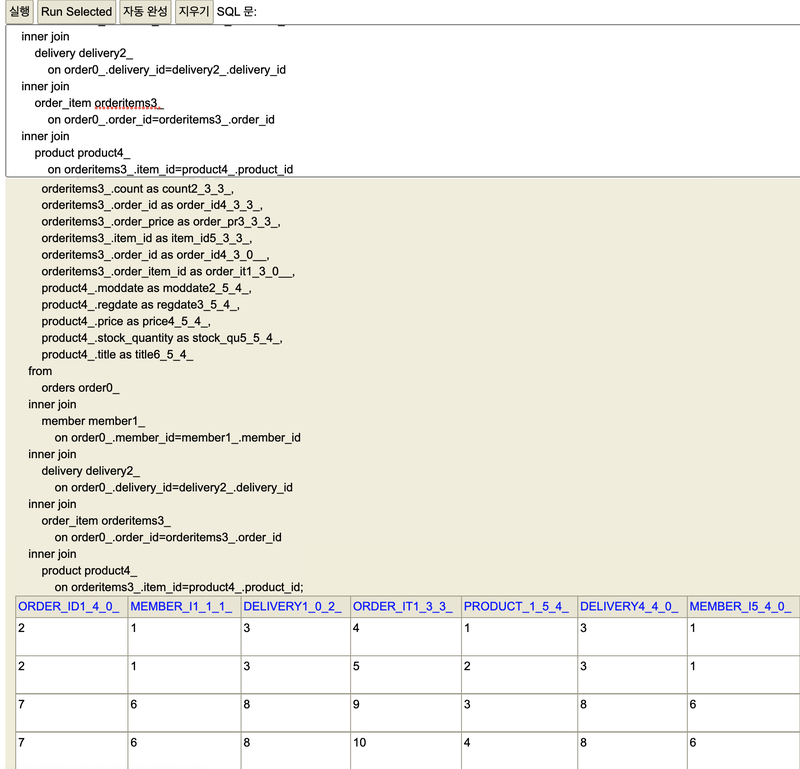
이 중복 데이터를 디비에서 어플리케이션으로 다~ 가져오는건데.. 데이터 전송량이 많아지는 것이다.
그에 비해 이번 포스팅에서 한 방식을 보자.
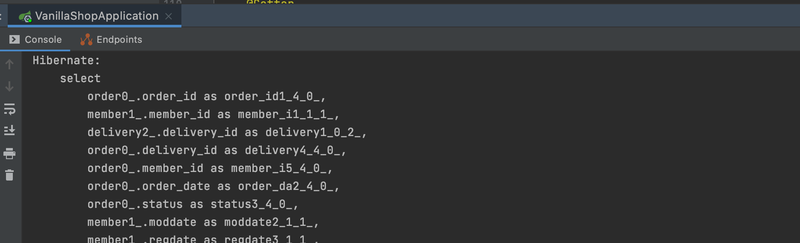
쿼리를 H2 디비에 복붙해서 확인!
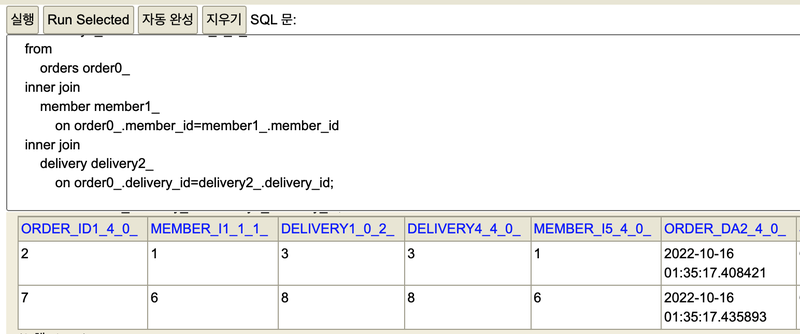
중복 없는 데이터가 나온다. (이 역시 2건, 4건이라 와닿지 않을 수 있지만 100개 1000개 라면!)
default_batch_fetch_size 덕분에.ㅎㅎ
📍 그래서 이번 포스팅 결론:
- default_batch_fetch_size 으로, 1:M:N 이 1:1:1이 되는 최적화가 가능하다.
- 컬렉션 페치 조인은 페이징이 불가능하지만 이 방법은 페이징이 가능하다.
- ToOne 관계는 페치조인을, 나머지는 default_batch_fetch_size 로 최적화 하자.
참고